大数据和 AI 结合应用,需要新的技术架构能力,从边缘和核心云计算节点的同步上,... 展开 >
大数据和AI结合的系统架构
会议室:宴会厅2出品人:胡月军
- Topic 1
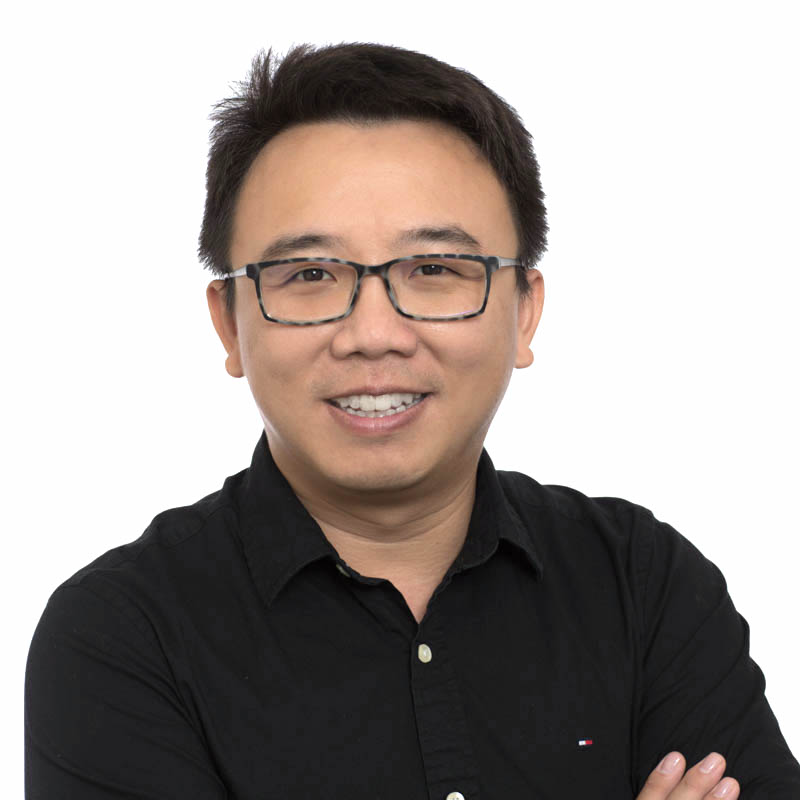
郭斯杰
StreamNative 联合创始人兼 CEO - Topic 2
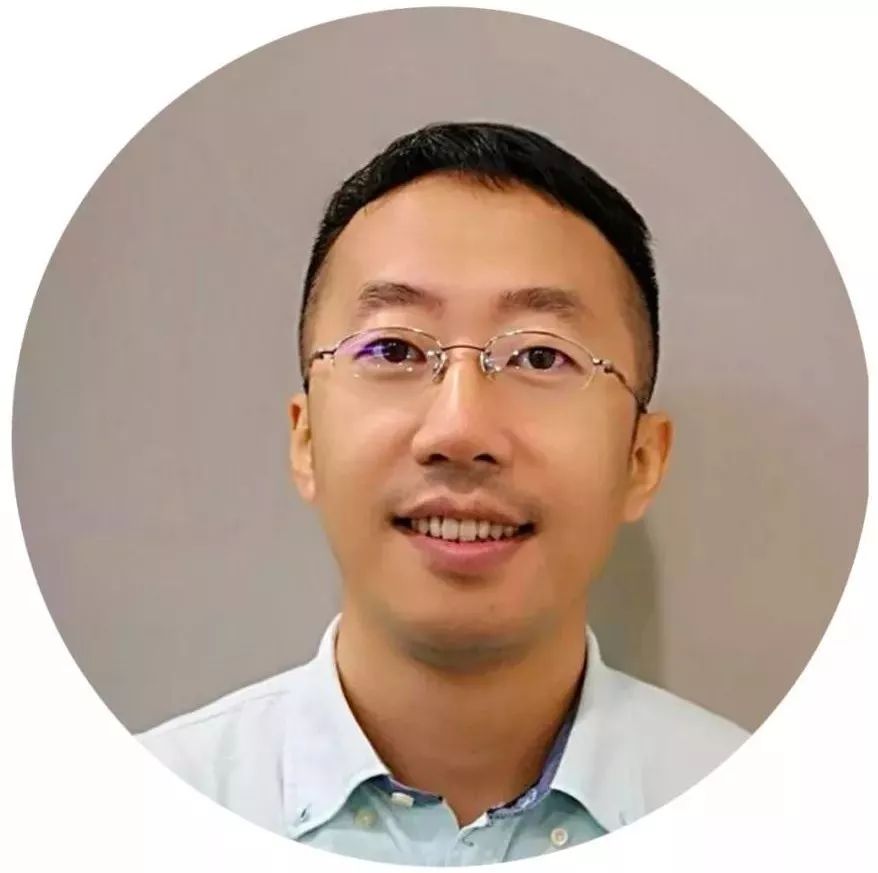
杨旭 博士
阿里巴巴 计算平台事业部/资深算法专家 - Topic 3
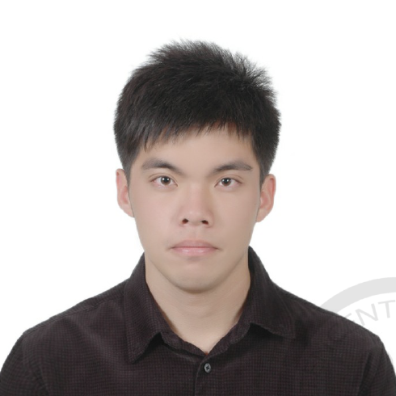
程力
腾讯云 高级工程师
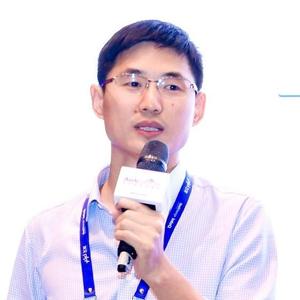
专题出品人:胡月军
阿里巴巴计算平台资深技术专家
花名一浪,从事5年搜索和广告引擎的设计与开发,负责过阿里巴巴淘宝,天猫,1688,Sourcing 和 AliExress 的搜索与广告在线引擎系统,主导过阿里巴巴国际搜索和广告引擎在离线的一体化升级改造。近3年来,主要从事存储与计算引擎的设计与研发工作。现就职于阿里巴巴计算平台事业部,发起和参与了阿里巴巴新一代交互式分析引擎 Hologres 的研发。
地点:宴会厅2
专题:大数据和AI结合的系统架构
大数据和 AI 结合应用,需要新的技术架构能力,从边缘和核心云计算节点的同步上,需要叠加升级从而更多地做数据协同运算,支撑未来各种各样的智慧城市、车联网、物联网等技术发展。
专题内容聚焦在流批一体机器学习平台建设、数据处理工具应用等话题方向。
by 郭斯杰
StreamNative
联合创始人兼 CEO当新生事物出现时,总有两种角度去观察它,要么把它看小,要么把它放大。对于 Apache Pulsar,把它看小的角度通常是“Apache Pulsar 只是一个新的消息队列而已“,或者“Apache Pulsar 只是一个新的数据管道而已”,“队列系统早就有了,只是 Apache Pulsar 更具扩展性也能解决某些场景问题而已,基本没啥本质区别”。很明显,上述种种认识都不对。
Apache Pulsar 作为 Apache 软件基金会顶级项目,是下一代云原生分布式消息流平台,集消息、存储、轻量化函数式计算为一体,采用计算与存储分离架构设计,目前项目和社区正在快速发展,已被国内外众多知名互联网企业和行业公司采用。
本次演讲中,郭斯杰将分享 Apache Pulsar 社区目前应用及最新进展,并探讨云原生时代在消息、流、数据管理和技术基础设施层面的技术演进。
演讲提纲:
- Pulsar 简介
- Queue 和 Stream 的融合
- 批流融合
- 云原生
- 消息、流和存储的融合
你将获得:
- 获取对 Apache Pulsar 基础架构和设计理念的认识
- 了解当前实时数据基础设施的挑战
- 介绍消息融合和批流融合的存储,带你了解云原生时代的运维
- 获取 Apache Pulsar 未来展望与规划
by 杨旭 博士
阿里巴巴
计算平台事业部/资深算法专家随着大数据时代的到来和人工智能的崛起,机器学习所能处理的场景更加广泛和多样。构建的模型需要对批量数据进行处理,为了达到实时性的要求还需要直接对流式数据进行实时预测,还要具备将模型应用在企业应用和微服务上能力。为了取得更好的业务效果,算法工程师们需要尝试更多更复杂的模型,需要处理更大的数据集,使用分布式集群已经成为常态;为了及时对市场的变化进行反应,越来越多的业务选用在线学习方式直接处理流式数据、实时更新模型。
演讲提纲:
- 平台简介
- 平台的应用场景
- 平台架构
- 流式应用案例
- 如何获取开源版本
- 未来规划
你将获得:
- 流式机器学习场景的典型解决方案
- 通过开源版本,可以快速尝试
by 程力
腾讯云
高级工程师随着存储计算分离的系统架构的出现,对象存储的弹性伸缩和低成本的优势使其在大数据和AI场景下逐渐成为更广泛的数据存储方案,数据湖的概念也应运而生。腾讯的数据湖方案中针对存算分离架构带来的性能问题和数据本地性的减弱,设计构建了新一代分布式计算端缓存层。该缓存不仅兼容 Hadoop 和对象语义,同时具备了结构化元数据管理的特性。利用表级别 MetaStore 等结构化元数据实现计算端按表粒度提供缓存,大幅优化了数据湖承载的大数据和 AI 应用的表级读写性能。该架构实现了数据湖的整体入湖和操作打通,针对大数据和 AI 场景提供了一体化的使用对象存储的方案。
演讲提纲:
- 存算分离架构的发展现状
- 如何解决计算数据本地性问题:三层加速的设计
- 在统一大数据和AI的数据湖生态下的规划和发展
- 对象存储如何在存算分离架构下结合 Iceberg 等结构化数据服务数据湖场景
- 对象存储在私有化场景下的架构探索
你将获得:
- 计算端缓存和统一语义在数据湖方案中的意义
- 缓存层如何结合 MetaStore 实现表粒度控制
- 腾讯数据湖如何向下一代存储数据结构 Iceberg 演进,承载 Iceberg+对象存储的存算分离方案
关注主办方(InfoQ)

联系我们
交通指南
上海·宝华万豪酒店
Shanghai Marriott Hotel Parkview
地址:上海市广中西路333号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86-18514549229

微信联系我们
小姐姐