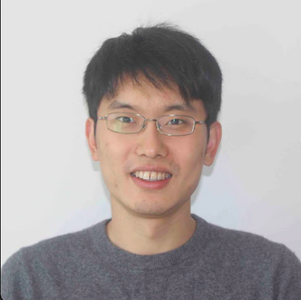
Databricks 资深工程师,于 2020 年加入 Databricks 中国团队,专注于 Apache Spark 的设计与研发。在加入 Databricks之 前曾供职于 Uber 及 LinkedIn,参与过多个开源大数据项目的研发与实践,在数据管理、流式计算、在线分析处理等方向上有丰富的经验。
Databricks Lakehouse Platform: Simple, Open, Collaborative
所属专题:应云而生的新一代数据架构
嘉宾 : 张泊 | Databricks资深工程师
会议室 : 宴会厅1
讲师介绍
议题介绍
地点:宴会厅1
所属专题:应云而生的新一代数据架构
演讲:Databricks Lakehouse Platform: Simple, Open, Collaborative
在过去的十年中,我们习惯性地将主流数据分析的基础架构分为数据湖和数据仓库两大类,他们各有利弊,无法充分解决当今数据分析和人工智能的不同需求。基于如上背景,Databricks 从统一、简化和开放的核心理念出发,提出 Lakehouse 架构。Lakehouse 将以全新的数据存储、管理和使用模式,致力于构建一个统一的数据分析和人工智能平台。
作为一种新架构,Lakehouse 将在扩展性、事务性以及灵活度上体现出其独到的优势。伴随着 Lakehouse 在用户实践中的逐步深入,我们也在持续解决如下来自用户场景的更高要求:
- 更开放的数据生态:Delta Lake and Delta Sharing
- 更易用的元数据管理:Unity Catalog
- 更高效的查询引擎:Databricks SQL
本次演讲将以如上 Lakehouse 的重要组件作为脉络,和大家分享 Databricks 在 Lakehouse 上的最新工作进展。
关注主办方(InfoQ)

联系我们
交通指南
深圳 · 大中华喜来登酒店
Sheraton Shenzhen Futian Hotel
地址:中国广东省深圳市福田区福华路福华路大中华国际交易广场

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:17310043226

微信联系我们
票务小姐姐