过去的20年里,大数据 & AI 系统的技术架构演进由三方面推动:海量数... 展开 >
应云而生的新一代数据架构
会议室:宴会厅1出品人:关涛(观滔)
- Topic 1
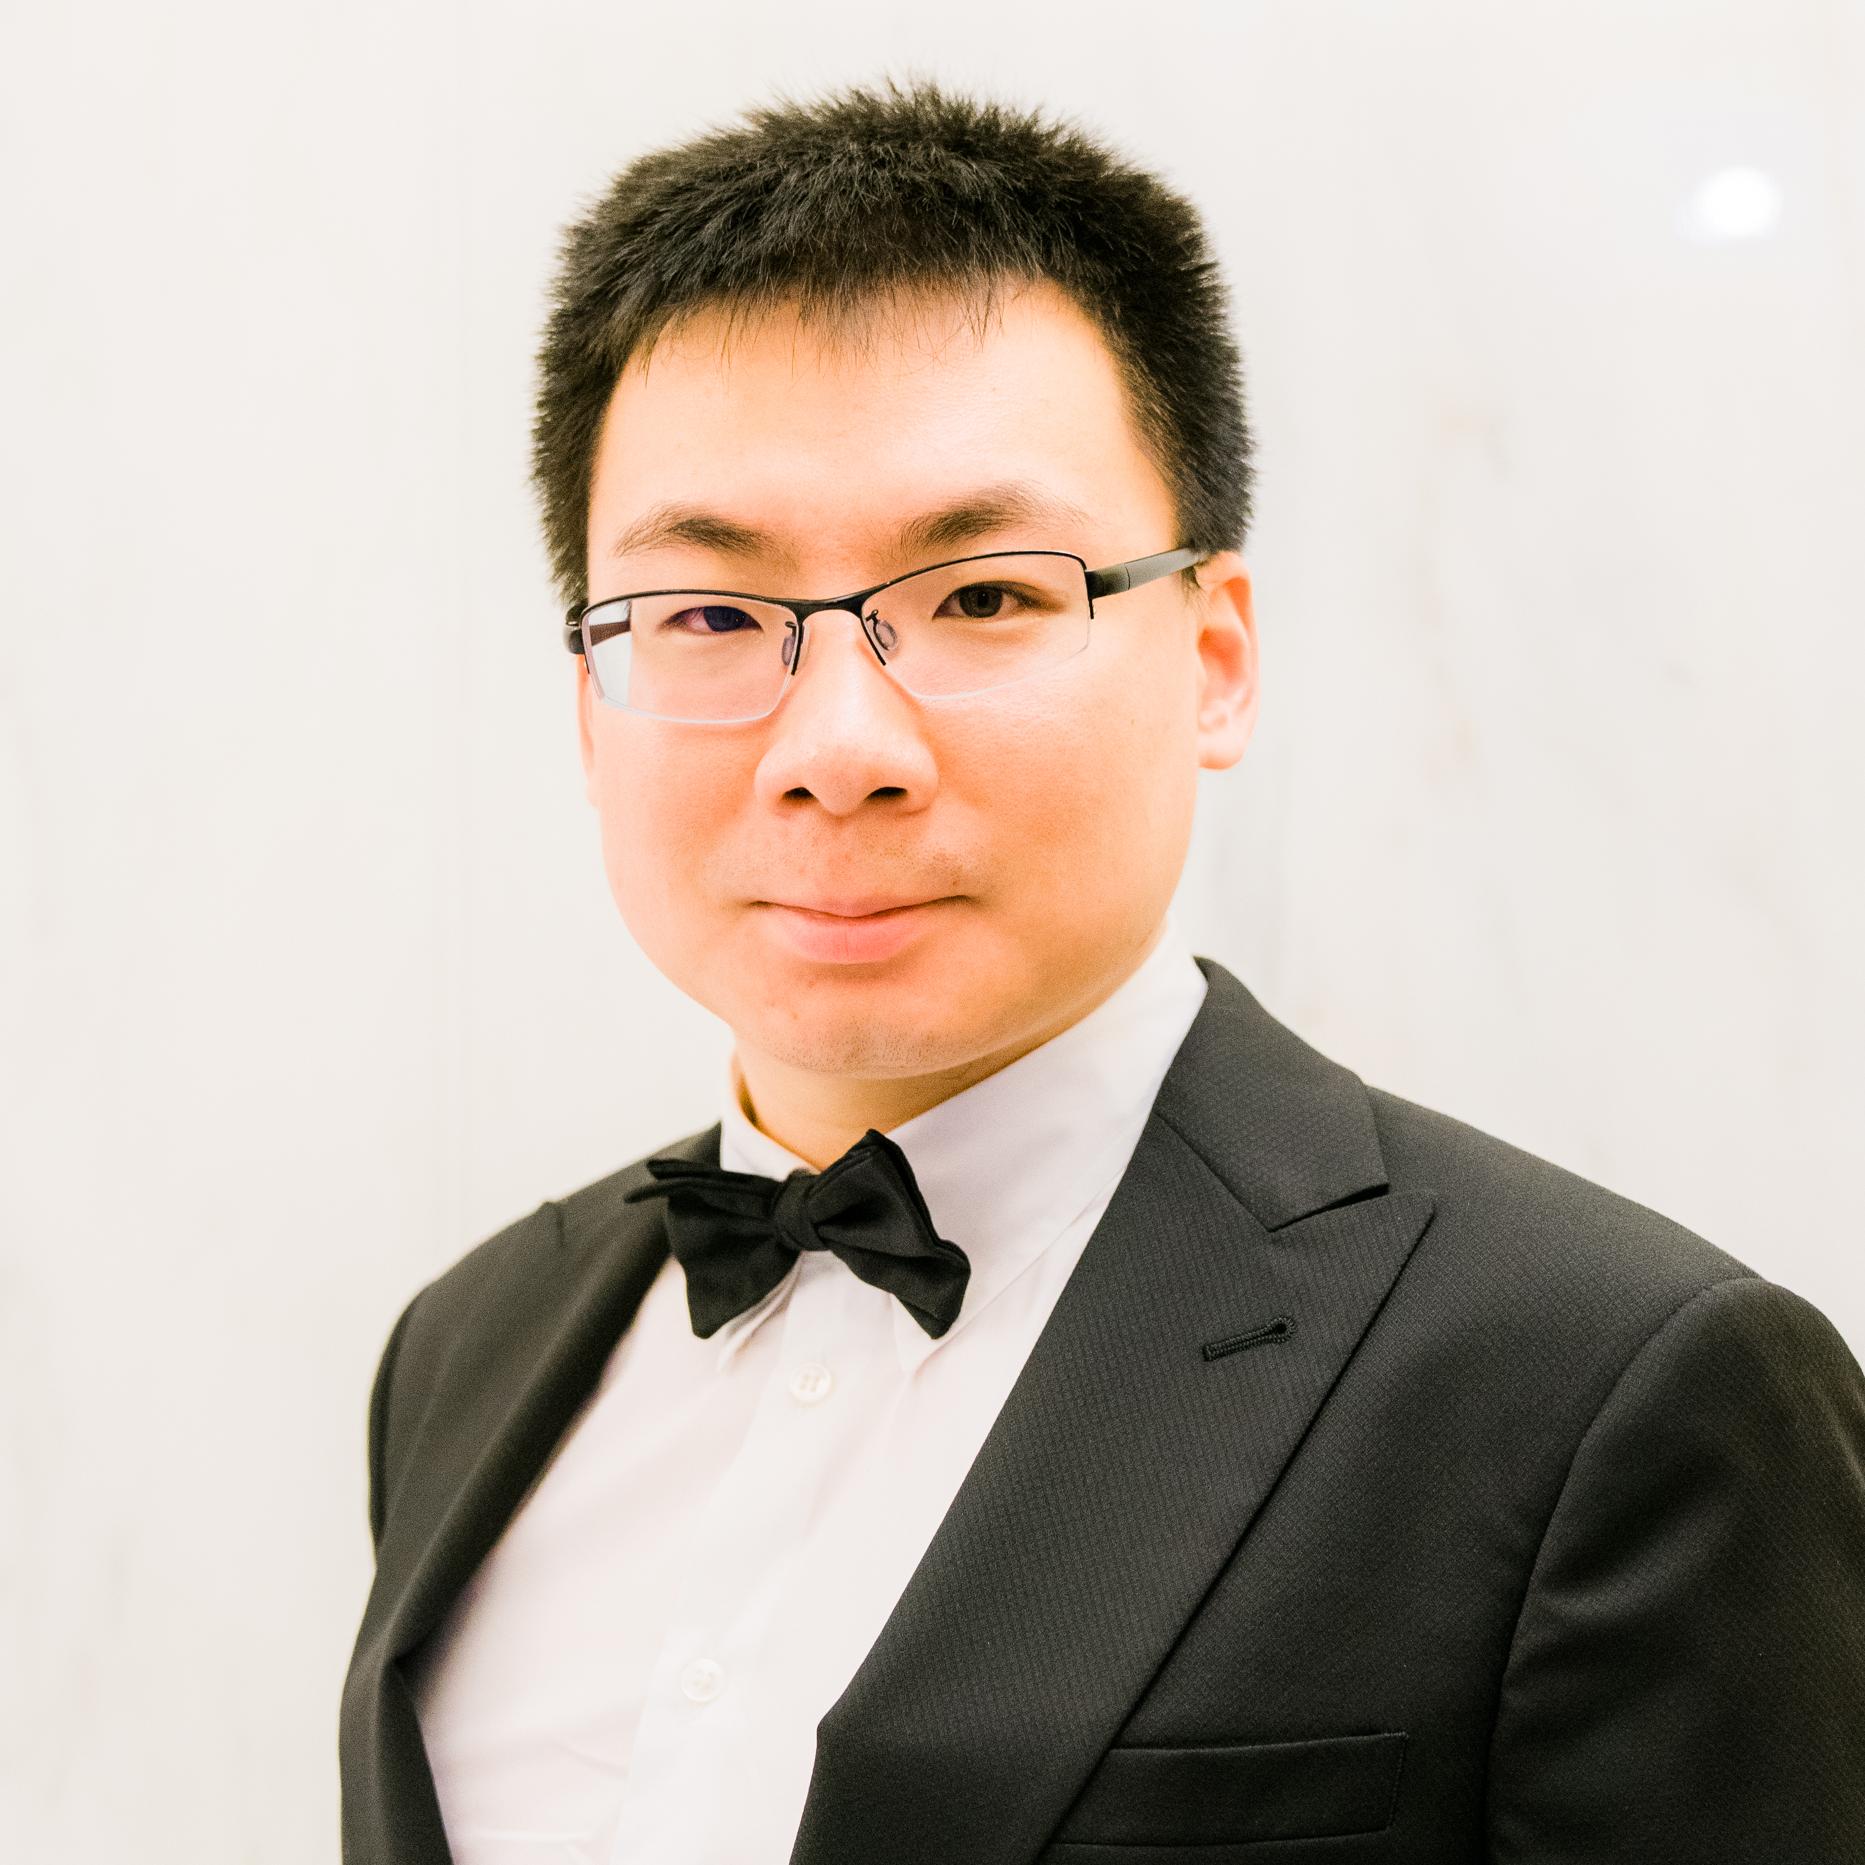
Jiaqi Yan
Snowflake Principal Software Engineer - Topic 2
张泊
Databricks 资深工程师 - Topic 3
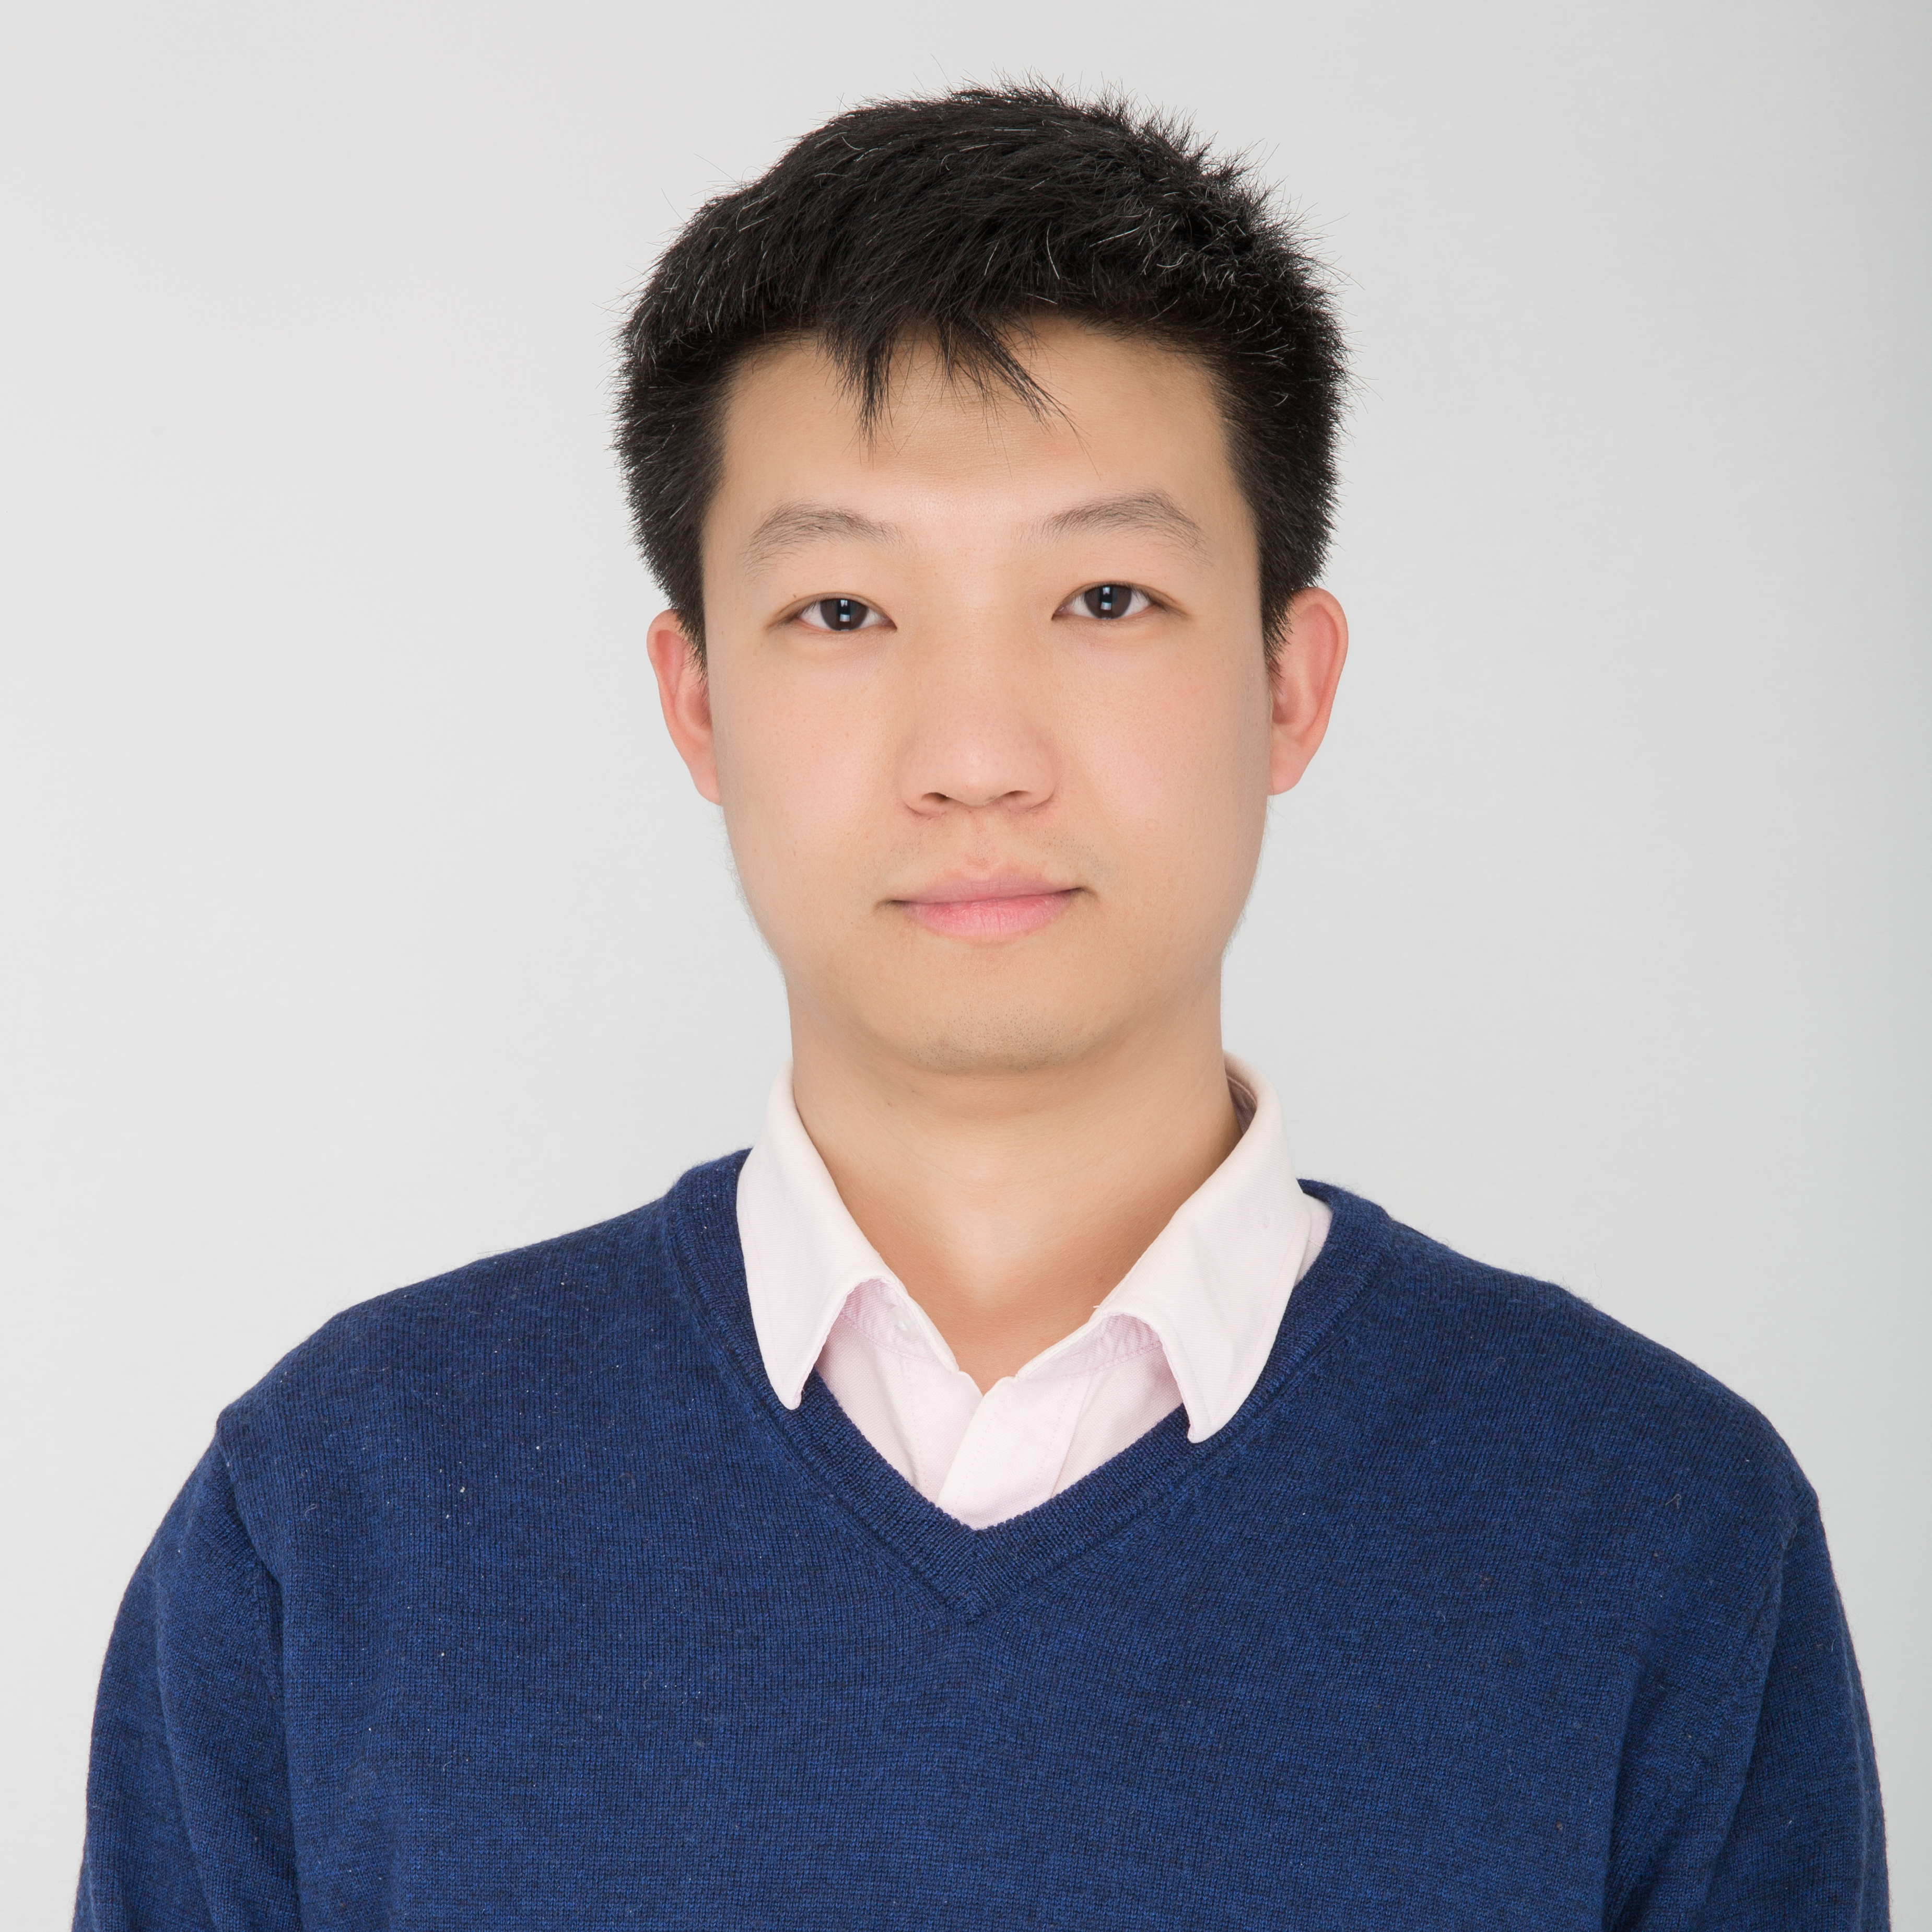
李睿博
阿里云 资深技术专家 - Topic 4
左琴
网易严选 数据总监、网易技术委员会委员
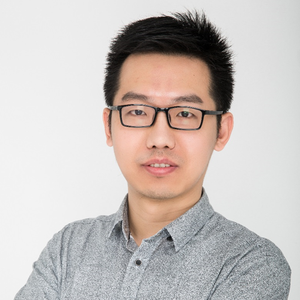
专题出品人:关涛(观滔)
分布式系统和大数据平台领域专家
关涛,分布式系统和大数据平台领域专家。曾任阿里云计算平台事业部研究员,阿里巴巴通用计算平台负责人,负责阿里巴巴主线大数据平台。前阿里巴巴和蚂蚁集团技术委员会计算平台领域组长、阿里云架构组大数据组组长。回国加入阿里云之前,在微软云计算和企业事业部工作 9 年,主持和参与开发了包括 Azure Datalake,Cosmos/Scope,Kirin Store,SearchRepository 在内的多套超大规模分布式存储和计算平台。并著有多篇国内外会议论文和专利。
地点:宴会厅1
专题:应云而生的新一代数据架构
过去的20年里,大数据 & AI 系统的技术架构演进由三方面推动:海量数据分析需求、开放开源的技术进步、以云为代表的软硬件基础设施升级。
本专题试从“云原生”的视角,与各位同行探讨新一代数据平台的架构迭代方向。包括但不限于统一数据存储(HDFS、OSS 等技术演进)、Caching 层(Alluxio/JindoFS 为代表)、统一资源管理的挑战(K8s 支持大数据计算的不足、混部技术)、统一元数据中心的技术演进、存算分离以及分布式内存池等等。
同时,尽管数据湖概念不强绑定在云,但云原生切实推动数据湖的普及化。数据湖的灵活性与数仓的管理能力成为大数据架构设计的“鱼”和“熊掌”,如何可兼得成为大厂架构体系演进的关键问题。2020年,AWS、Databricks、阿里云同时提出“湖仓一体”概念,尽管有相同的目标,演进路径“一中各表”。“湖仓一体”能否真正落地?路径是怎样的?本专题也将特邀相关团队一线专家共同探讨。
by Jiaqi Yan
Snowflake
Principal Software EngineerThe Snowflake Data Cloud is a new type of cloud dedicated to data analytics, built on top of the infrastructure provided by the three major cloud providers, namely Amazon, Microsoft, and Google. In this talk, I will give an overview of the Snowflake cloud data platform, highlighting how we leverage the cloud to make Snowflake infinitely scalable, elastic, global, collaborative, and extremely simple to use. In particular, we will show that this is made possible by our multi-cluster shared-data architecture. This novel architecture, specifically designed for the cloud, allows unlimited and independent scaling of both compute and storage, with instant elasticity along both dimensions. The Snowflake cloud data platform is globally distributed, making it one single multi-tenant platform for the world. This enables collaboration between tenants, for example allowing one tenant, a provider, to share a secure view of a database with one or more tenants, referred to as consumers. Our multi-cluster shared-data architecture enables live data sharing without the need to share any compute resources, resulting in full isolation between providers and consumers.
by 张泊
Databricks
资深工程师在过去的十年中,我们习惯性地将主流数据分析的基础架构分为数据湖和数据仓库两大类,他们各有利弊,无法充分解决当今数据分析和人工智能的不同需求。基于如上背景,Databricks 从统一、简化和开放的核心理念出发,提出 Lakehouse 架构。Lakehouse 将以全新的数据存储、管理和使用模式,致力于构建一个统一的数据分析和人工智能平台。
作为一种新架构,Lakehouse 将在扩展性、事务性以及灵活度上体现出其独到的优势。伴随着 Lakehouse 在用户实践中的逐步深入,我们也在持续解决如下来自用户场景的更高要求:
- 更开放的数据生态:Delta Lake and Delta Sharing
- 更易用的元数据管理:Unity Catalog
- 更高效的查询引擎:Databricks SQL
本次演讲将以如上 Lakehouse 的重要组件作为脉络,和大家分享 Databricks 在 Lakehouse 上的最新工作进展。
by 李睿博
阿里云
资深技术专家湖仓一体是近年来大数据领域最炙手可热的概念。湖仓一体的出现进一步模糊了数据湖系统和数据仓库系统之间的边界。例如对事务支持、数据治理、BI 支持,可以使得一个原本的数据湖系统相当程度上具备了数仓的能力;而强调存算分离、开放格式、以及多工作负载等,又可以使得一个原本数据仓库的系统具备了数据湖的能力。但是对于企业来说,根据所处阶段的不同,已有历史选型的不同,其大数据系统建设所面临的痛点,以及湖仓一体所能带来的价值点也不尽相同。本次演讲将通过对阿里云湖仓一体落地的典型客户案例的分析,向大家分享阿里云对于湖仓一体的思考以及最新的工作进展。
演讲提纲:
1. 阿里云湖仓一体架构介绍
- 数据湖背景下的业务痛点
- 阿里云湖仓一体架构及关键技术
2. 典型案例落地分析
- 休克式搬站 vs 渐进式替换
- 低成本高弹性算力补充、大规模机器学习
- 统一数据资产管理、湖仓一体的数据中台
3. 阿里云湖仓一体下一步展望
你将获得:
- 了解阿里云大数据湖仓一体的关键技术
- 湖仓一体的适用场景和实际落地路径
by 左琴
网易严选
数据总监、网易技术委员会委员数据架构的演进包含了多个不同维度的目标:数据运转的效率,时效,系统的整体成本,性能,系统的可扩展性与可维护性,数据的安全等等。 由于业务形态的差别,不同的公司对数据体系的要求是很不一样的,这就要求数据团队在做架构选型时,要根据业务形态对数据的要求,选取合理的技术方案。同时,业务本身也在成长和变迁,因此在设计数据架构的时候,不仅要解决眼前的痛点,也要解决未来的问题。 基于上面的考量,网易在考虑数据架构的演进时,主要关注的是:1. 数据体系运转的效率;2. 系统的整体成本; 3. 系统的可扩展性与可维护性。本次演讲将会分享网易严选数据团队基于这些目标,持续在做的工作:包括 AutoETL、湖仓一体实践的融合等等内容。
演讲提纲:
1. 网易严选数据架构介绍
- 网易严选数据及算法架构 Landscape
- 架构背后的设计理念
2. 更快的数据运转效率
- 务实的批流一体方案
- AutoETL
- 指标、模型与自动化 SQL
- 从数据集成到数据服务
3. 系统的整体成本/可扩展性
- 存算分离实践
- 批/流/训练/推理、Clound Native
你将获得:
- 对大数据与 AI 的工程技术体系能有整体的认识
- 对如果做好数据架构选型提供了可供参考的方法论
- 了解网易在 DataLake 为基础上,在批流一体、AutoETL 等方向的具体实践
- 了解存算分离、混部、云原生对大数据和 AI 带来的价值和具体实践
关注主办方(InfoQ)

联系我们
交通指南
深圳 · 大中华喜来登酒店
Sheraton Shenzhen Futian Hotel
地址:中国广东省深圳市福田区福华路福华路大中华国际交易广场

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:17310043226

微信联系我们
票务小姐姐