北京大学机器学习硕士,10 年华为工作经验,从 0 到 1 构建华为机器翻译模型,参与华为机器翻译模型的每个语种训练调优。华为机器翻译模型现已支持近 100 种语言互译,除了有力支撑华为 30 万员工内部办公交流等场景外,还支撑着华为各个产品和服务的机器翻译,包括华为手机、华为音箱、华为手表和 HMS 以及华为云等业务。
参加国际机器翻译比赛 WMT、IWSLT、WAT 等,获得多项第一名,现已发表 20+ 论文和专利。
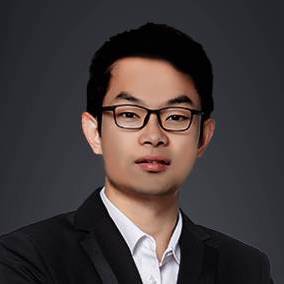
北京大学机器学习硕士,10 年华为工作经验,从 0 到 1 构建华为机器翻译模型,参与华为机器翻译模型的每个语种训练调优。华为机器翻译模型现已支持近 100 种语言互译,除了有力支撑华为 30 万员工内部办公交流等场景外,还支撑着华为各个产品和服务的机器翻译,包括华为手机、华为音箱、华为手表和 HMS 以及华为云等业务。
参加国际机器翻译比赛 WMT、IWSLT、WAT 等,获得多项第一名,现已发表 20+ 论文和专利。
机器翻译是深度学习典型的端到端落地的场景,但是一个好的机器翻译模型,往往需要数以亿计的高质量双语语料来训练。如何在如此大规模的数据训练中提升速度,是一个需要关注的问题。同时机器翻译模型也非常庞大,如何支撑大模型的高效推理也是机器翻译落地中需要解决好的大问题。
华为机器翻译模型使用华为自研机器学习框架 Mindspore + 华为的昇腾芯片,并且通过优化模型结构和训练策略提升训练速度,通过“模型结构优化 + 华为自研推理框架 Optimus + 机器翻译定制的优化算子”提升推理速度。优化后机器翻译模型训练速度可以提升 5 倍多,推理速度提升 20 倍。
本次分享将给你带来华为机器翻译模型训练推理加速实践。
演讲提纲:
你将获得:


 京公网安备 11010502039052号 | 产品资质
