大数据平台技术不断升级换代,各类数据开发与数据服务的模式日新月异,DataOps... 展开 >
DataOps、Data Fabric等高效数据开发与服务模式
会议室:会议室1(三楼)出品人:蔡适择
- Topic 1
王洋
字节跳动 抖音直播数据研发负责人 - Topic 2
宋东辉
网易云音乐 资深测试开发工程师 - Topic 3
徐振中
Claypot AI 联合创始人兼 CTO - Topic 4
许俊
顺丰科技 大数据产品专家
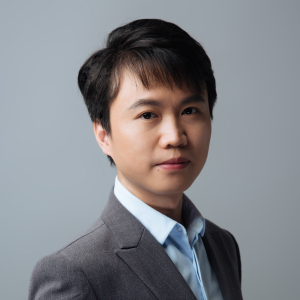
专题出品人:蔡适择
顺丰科技大数据总监
负责顺丰大数据平台底盘建设及产品化工作,完成顺丰大数据平台从0至1的整个建设过程,之前负责京东实时计算平台从0至1的整体建设。在大数据平台、物联网、边缘计算领域有丰富的实践经验,深耕大数据平台存算分离、实时数仓、融合计算等技术,致力于大幅降低数据开发及应用门槛,让大数据技术成为一项人人可用、可快速应用的技术。
地点:会议室1(三楼)
专题:DataOps、Data Fabric等高效数据开发与服务模式
大数据平台技术不断升级换代,各类数据开发与数据服务的模式日新月异,DataOps、Data Fabric、主动元数据等新的数据交付模式让平台、工具、人三者之间的协作联动方式有显著变化,平台沉淀的越来越多的数据、资源也逐步成为了成本上升的主要推手,但具体能够为企业带来什么哪些改善、存在哪些坑、后续又将如何演进等很多人都不清楚,ChatGPT 的出现,是否能够为数据的交付模式带来新的局面,本专题将邀请大数据平台、数据治理方面的一线技术专家来分享他们的实践。
by 王洋
字节跳动
抖音直播数据研发负责人数据研发作为企业数智化的重要环节,相较于业务系统研发,在需求管理、模型设计、代码开发、测试上线等流程及对应的产品功能上都处于初期阶段,DataOps作为当前数据研发管理实践的重要方向。
本次分享将围绕字节跳动所面临的数据规模大、需求量多、场景复杂等具体挑战,结合DataOps理念与字节现有研发工具体系,提供数据需求在交付全链路上的质量与效率提升的一种思考。
演讲提纲:
- 字节跳动数据研发所面临的挑战
- DataOps 理念在字节的具象
- 基于 DataOps 的数据研发管理
- DataOps 的产品化方案
- 规范+产品在字节落地的最佳实践
- 未来数据研发的展望
你将获得:
- 了解字节跳动数据团队在复杂的业务挑战中关于 DataOps 的思考和落地经验
- 理解从需求管理到业务价值评估的完整方案
- 了解数据研发工作未来的模式思考
by 宋东辉
网易云音乐
资深测试开发工程师云音乐数据研发模式的痛点:
- 数据研发模式需要突破,进一步提升研发效率
- 研发自测效率低,无明确的质量准出标准
- 数据监控覆盖率和准确率较低,研发无法及时感知数据线上问题
方案介绍:
从各类保障工具建设,到“变更巡检”,我们逐步坚定规范研发流程才是解决研发痛点的关键,于是基于 DataOps 理念,结合云音乐实际情况落地!
DataOps 的建设初衷是保障数据质量,其终局是“协调多方高效合作,辅助研发敏捷开发!”
- 事前:从平台层面,规范需求评审、数据指标评审等动作和文档模版要求
- 事中:提供代码diff和扫描能力,辅助研发快速定位变更点和问题点;
- 完善数据质量检测能力,基于数据质量准出标准提供自动化检测卡点能力,辅助研发自测,强制推动研发完成必要工作(例如数据测试用例、数据监控等)
- 事后:基于规范巡检兜底数据研发全量变更,保障变更质量;此外,通过监控告警通知等手段,闭环治理数据监控,提升数据线上问题召回率,降低问题影响时长。
效果说明:
- 云音乐核心项目需求研发周期从22年H2的39天降低到23年H1的33天,实现了研发效率提升;数据需求延期交付率从50%降低到30%。
- 云音乐数据线上问题数量,比22年H2降低40%,研发规范类问题降低50%。
- 2023年H1(事后)累计召回数据问题31例,线上问题召回率提升到70%;核心业务监控月度误报量下降50%以上。
演讲提纲:
- 云音乐大数据业务&痛点介绍
- DataOps 项目内容
- 研发规范
- 自动化卡点
- 规范巡检&监控治理
- 效果收益
- 后续规划
你将获得:
- 云音乐数据研发效率提升和研发质量保障的解法
- 云音乐数据线上问题治理的难点和实战
by 徐振中
Claypot AI
联合创始人兼 CTOComplexities You Should Care about a Simple Real-time ML Abstraction
If you are a data scientist or a platform engineer, you probably can relate to the pains of working with the current explosive growth of Data/ML technologies and toolings. With many overlapping options and steep learning curves for each, it’s increasingly challenging for data science teams. Many platform teams started thinking about building an abstracted ML platform layer to support generalized ML use cases. But there are many complexities involved, especially as the underlying real-time data is shifting into the mainstream.
In this talk, we’ll discuss why ML platforms can benefit from a simple and “invisible” abstraction. We’ll offer some evidence on why you should consider leveraging streaming technologies even if your use cases are not real-time yet. We’ll share learnings (combining both ML and Infra perspectives) about some of the hard complexities involved in building such simple abstractions, the design principles behind them, and some counterintuitive decisions you may come across along the way.
By the end of the talk, I hope data scientists can walk away with some tips on how to evaluate ML platforms, and platform engineers learned a few architectural and design tricks.
如果你是一名数据科学家或平台工程师,您可能很容易体会到当前数据和机器学习的工具呈爆炸式增长,以及这个趋势给你所带来的困扰。 由于每个工具太过繁复和陡峭的学习曲线,这对数据科学团队来说越来越具有挑战性。 许多平台团队开始考虑构建一个抽象的 ML 平台层来支持通用的 ML 用例。 但是其中涉及许多复杂性,尤其是在处理实时或近实时 ML 时,会表现的尤为明显。
在本次演讲中,我们将讨论一个简单而“隐形”的抽象层,及这个抽象层的技术意义。 我们将提供一些证据和观点,说明为什么您应该考虑利用Stream Processing,尽管你可能已经听到了所有艰巨的挑战。我们将分享一些关于构建这种简单抽象时所涉及的困难复杂性的经验教训(结合机器学习和基础架构的视角),抽象背后的设计原则以及你可能会遇到的一些违反直觉的决策。
在演讲结束时,我希望技术和商业领导能更深刻的理解为什么实时ML/AI是未来的趋势,也希望数据科学家能够了解一些有关如何更有效地处理机器学习工作流程的,而平台工程师则能够学习到一些可以使你的组织具备未来性的架构和设计技巧。
by 许俊
顺丰科技
大数据产品专家DataOps 是大数据研发体系的重要理念,顺丰大数据也在过去的几年中通过各种办法来提高各个环节的开发效率,但也逐渐遇到了提效手段分散不成体系、提效边际效应递减等困境。
近年来,随着 AI 技术的发展和算力的增强,尤其是 ChatGPT 对 AIGC 质量的提升,为提效打开了新的思路。顺丰大数据尝试在 DataOps 体系中融入了智能化的能力,希望能成体系的大幅提升数据开发的效率,同时也大幅降低开发门槛。
演讲提纲:
- 顺丰大数据简介
- DataOps 提效手段和困境
- ChatGPT 带来的新机会
- ChatGPT 在顺丰大数据的探索
- 未来计划
你将获得:
- 顺丰大数据在 DataOps 智能化方面的实践经验
- 大数据开发整体智能化的后续方向探讨
前沿亮点:
- 将 ChatGPT 能力融入到数据开发过程,为开发工具注入智能能力
- 可插拔的产品和技术架构体系
关注主办方(InfoQ)

联系我们
交通指南
深圳·博林天瑞喜来登酒店
Sheraton Shenzhen Bolin Tianrui Hotel
地址:广东省深圳市南山区留仙大道4088号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质
如您在购票过程中遇到问题,请扫码咨询票务小姐姐