拥有12年机器学习、分布式计算、并行计算加速等相关领域经验,负责研发了腾讯AngelPTM大模型训练框架,支持6D并行和ZeROCache优化策略,支持以更少资源以更快的速度训练更大的模型,目前AngelPTM支持了腾讯混元大模型的训练以及内部业务应用的精调和强化训练。
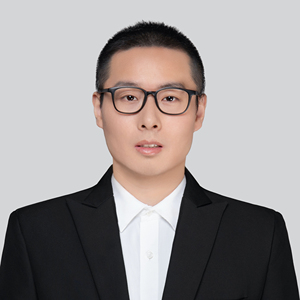
专题演讲嘉宾:薛金宝
腾讯机器学习平台部大模型训练框架研发技术专家
by 薛金宝
腾讯
机器学习平台部大模型训练框架研发技术专家在大模型蓬勃快速发展的今天,不仅要支持文生文、多模态、文生图、文生视频等的大模型训练,还要支持 Dense 和 MoE 模型的训练,不仅要支持小模型的训练,还要支持万亿参数模型的训练,不仅要支持单任务单卡大模型的训练,还要支持单任务万卡规模大模型的训练,不仅要支持同构 GPU 的训练,还要支持异构GPU的加速训练,如何满足大模型训练的多种加速需求,成为大模型 AI Infra 的必须解决的挑战。
解决方案:基于对存储、网络、计算的深度融合优化,我们研发了 AngelPTM 大模型训练框架,其通过6D并行策略提高模型的训练并行度、通过 ZeROCache 解决大模型训练显存压力大的问题,通过 MOE 加速组件解决超大规模参数模型高效训练的问题,通过与星脉高速网络的协同优化,与算力、服务器、存储等团队的通力配合来解决单任务万卡训练的问题。
实施后效果:AngelPTM 支持文生文、多模态、文生图/视频等大模型的高速训练,单任务万卡训练可实现长时间的稳定高性能训练。
演讲提纲:
- 大模型训练发展趋势和面临的挑战
- 万物生文、万物生图、万物生视频等大模型发展趋势。
- 大模型训练通信挑战
- 大模型训练显存挑战
- 大规模训练计算挑战
- 大模型训练框架 AngelPTM
- AngelPTM 6D 并行加速
- AngelPTM ZeroCache 存储优化技术
- AngelPTM MOE 加速优化
- AngelPTM 大窗口优化
- 大模型超大规模集群训练优化和实践。
- 超大规模训练线性扩展性优化
- 超大规模训练稳定性优化
听众受益点:
- 大模型训练针对各种模态模型优化手段(各种模态支持)
- 针对超大规模训练以及业务落地训练的优化手段(万卡训练和单卡训练)
- 针对 MOE 大模型的训练优化手段
- 万卡以上超大规模训练如何实现性能的线性扩展以及训练稳定性保障
关注主办方(InfoQ)

联系我们
交通指南
深圳博林天瑞喜来登酒店
Sheraton Shenzhen Nanshan
地址:广东省深圳市南山区留仙大道4088号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质
如您在购票过程中遇到问题,请扫码咨询票务小助手