10年以上工作经验,在用友、去哪儿网、TalkingData 和小米工作,先后做过开发和产品。目前在小米集团人工智能部负责自然语言理解质量平台。
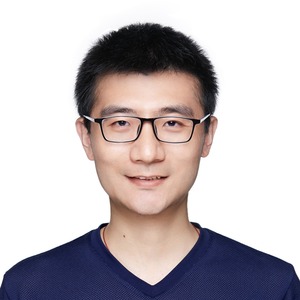
专题演讲嘉宾:彭嘉
小米NLU质量平台负责人
by 彭嘉
小米
NLU质量平台负责人人工智能的发展,需要依靠算法+数据+算力的相互协作。任何人工智能应用开发的过程中,针对数据永远会遇到,算法指标好,真的可以上线么,多次评测指标波动怎么解释?那么指标波动涉及哪些影响因素,我们怎么降低负面影响。
例如:一、如何看待指标波动,测试集多大规模合适——测试集是不是要和庞大的训练集一样,1~3天才能看到运行结果?二、需要区别的标签太多,如何获得高质量的评测集——低质量的训练/评测集,可能会因为数据滥用导致模型偏见永久化。三、上线前需要设计哪些环节,才能保障线上体验。
演讲提纲:
- 常见问题:评测算法指标过高的问题;多次评测指标波动怎么办;
- 影响指标波动的因素及小爱的处理方法:
- 影响因素简介:
- 评测集的代表性;
- 分类标签是否边界清晰好标注;
- 标注同学的素质;
- 评测环境稳定性;
- 图谱数据的准确性和更新频率
- 保障评测集代表性的方案,数据集规模量级和指标波动阈值的关系,并给出公式推导
- 小爱语义有2K多个语义标签,如何保障这些分类标签正交化,有边界冲突后怎么处理
- 小爱有2W多个槽位标签,如何保障知识图谱结果和用户认知一致
- 基于DNN NER 模型的槽位辅助工具的创新应用
- 影响因素简介:
- 小爱模型上线经历的质量验证流程和使用的数据集简介
你将获得:
- 了解指标波动的深层次原因,获得宏观解决方案的科学性证明过程(公式推导)和业务经验值
- 小爱上线前的质量保障流程的交流借鉴
- NLP 标注标签正交化(多个标签语义不冲突)的相关经验
关注主办方(InfoQ)

联系我们
交通指南
北京·富力万丽酒店
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质
票务小姐姐